Estudo com dados públicos e IA: como o Retrato das Empresas do Brasil foi feito
Estudo com dados públicos e IA na prática: 41 edições da Receita, vinte fontes, 602 números com consulta e o que quebrou no Retrato das Empresas do Brasil.
Ficha
- stack
- Claude Code + DuckDB + Python
- tempo
- 28/09 a 09/10/2026
- resultado
- 602 números com consulta, 0 falhas
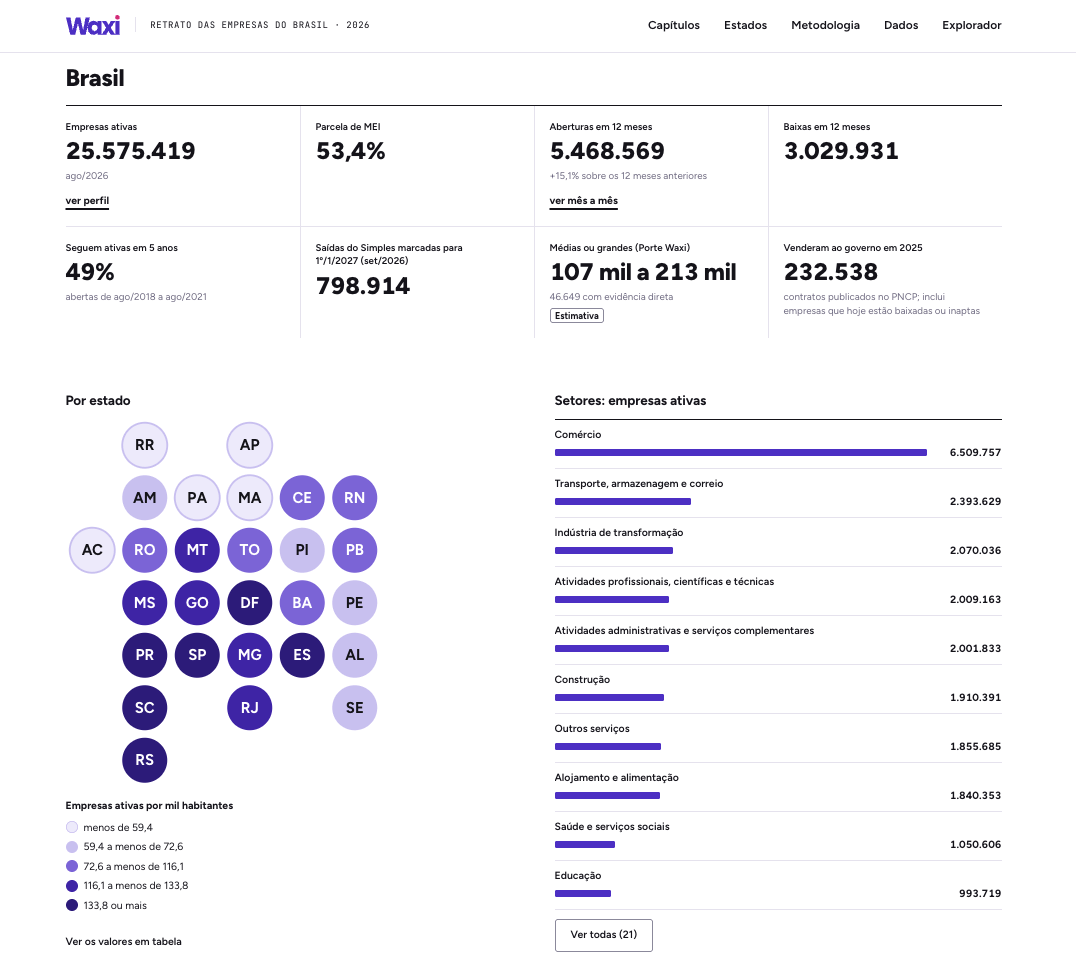
Em 9 de outubro de 2026 a Waxi publicou o Retrato das Empresas do Brasil 2026, um estudo com dados públicos e IA sobre as 25,6 milhões de empresas ativas no cadastro da Receita Federal. Mais da metade, 53%, é MEI. Dependendo do critério, entre 107 mil e 213 mil são médias ou grandes, e só 47 mil têm evidência direta disso em alguma régua: balanço na CVM, trabalhadores no PAT1 ou capacidade registrada num regulador. A base são 41 edições mensais do cadastro de CNPJ da Receita, 260 GB de arquivos compactados, cruzadas com mais de vinte fontes públicas, do IBGE à dívida ativa da PGFN2.
O repositório3 do estudo tem 92 commits4 entre 28 de setembro e 9 de outubro, e eu não escrevi o código. Escrevi o que o estudo precisava responder, decidi o que entra e o que fica de fora e revisei o que saía; um agente5 de IA fez o resto. Ou seja: o custo de fazer um estudo sério com dado público caiu de "projeto com time de dados" pra "um diretor, um agente e um SSD externo". O que não caiu foi o custo de estar errado, porque número público errado fica indexado pra sempre. Este post é sobre isso: como o dado foi tratado, o que quebrou no caminho e as regras que fazem um estudo feito com IA aguentar revisão.
O que o retrato mostra
A tese do estudo cabe numa frase: o cadastro mistura a empresa que existe, a que emprega e a que opera em escala, e as três são populações muito diferentes.
| Camada | Empresas | Fonte |
|---|---|---|
| Ativas no cadastro | 25,6 milhões | Receita, agosto de 2026 |
| Com empregados assalariados | 2,65 milhões | IBGE, 2022 |
| Médias ou grandes, conforme o critério | 107 mil a 213 mil (estimativa) | Porte Waxi, 2026 |
| Com evidência direta de porte | 47 mil | PAT, CVM e reguladores |
| Com ao menos mil trabalhadores no PAT | 2.448 (piso) | PAT, março de 2026 |
Das abertas entre agosto de 2018 e agosto de 2021, 49% continuavam ativas cinco anos depois. Em 2025 foram 5,02 milhões de aberturas, recorde, e 799 mil empresas têm saída do Simples ou do SIMEI marcada pra 1º de janeiro de 2027. Dos R$ 366 bilhões em benefícios fiscais federais declarados em 2025, 73% estão com 889 empresas. Tudo isso está nos onze capítulos e na metodologia do estudo. Aqui o assunto é o que fica atrás dos capítulos.
Como o dado foi tratado
Do zip da Receita ao Parquet
A Receita publica o cadastro todo mês em dez partes de empresas, dez de estabelecimentos, dez de sócios e uma do Simples, uns 7,5 GB por edição, num servidor que só responde pra IP brasileiro e cai no meio do download. Cada edição vira Parquet6 via DuckDB7, com os arquivos grandes lidos em pedaços de 1,2 GB, e só com as colunas analíticas: razão social, nome fantasia, CPF de sócio, telefone e e-mail não entram no disco de trabalho. No total, 260 GB de zip viraram 71 GB de Parquet, e cada um dos 1.573 arquivos baixados tem data de coleta e SHA-2568 registrados no repositório.
Uma linha por empresa, e quatro universos
Empresa é o CNPJ matriz; filial conta só como unidade. O CNPJ também cadastra associação, condomínio, igreja, partido e órgão público, então o estudo define quatro universos e usa por padrão o das entidades empresariais e pessoas físicas com CNPJ, comparável ao Mapa de Empresas do governo. Candidato a cargo eletivo fica fora de todos: cada eleição abre cerca de 500 mil CNPJs de campanha que fecham meses depois, e sem esse corte todo ano par parece ter um boom de abertura que nunca existiu.
Fontes de fora como régua
O cadastro diz que a empresa existe. Não diz se ela emprega nem quanto fatura. Pra isso entraram o PAT, a CVM (receita de 668 companhias abertas), o BNDES, a PGFN, a CGU, o PNCP e seis reguladores: ANS, CNES, ANEEL, ANP, Inep e Anatel. Cada fonte tem processador próprio, licença conferida e total batido contra o que o próprio órgão publica; na ANS, o estudo chega a 90.189.933 beneficiários contra 90.191.622 oficiais. Disso sai o Porte Waxi, que classifica cada empresa em duas réguas separadas, receita e emprego, com confiança de A a D conforme a evidência.
O que quebrou
Dado público brasileiro tem defeito na origem, e a IA não desconfia sozinha. Cada item abaixo virou um teste no repositório depois de descoberto.
- O PAT dava a uma única operadora de saúde do interior do Rio 447.840 trabalhadores em dois registros. É mais que o Banco do Brasil inteiro e mais de três vezes a população da cidade dela. Três registros assim saíram da contagem, com motivo e data gravados, e um teste falha se aparecer outro estabelecimento acima de 50 mil sem revisão.
- A edição de outubro de 2024 da Receita veio defeituosa de fábrica: um arquivo de estabelecimentos repete o conteúdo de outro, 4.457.710 matrizes em dobro, e 1,5 milhão de empresas ativas somem naquele mês e voltam em novembro. A edição ficou fora da série, e o intervalo de setembro a novembro é tratado como um só.
- Em agosto de 2023 a Receita republicou quatro arquivos truncados com outro sufixo e manteve os originais quebrados no ar. O ingest aprendeu a escolher o válido.
- A tabela de CNAE9 da Receita corta descrições em 150 caracteres e tem "Atividade Econônica" com dois enes. Os nomes agora vêm do IBGE.
- O PNCP registra valores de contrato com erros grosseiros. O estudo usa só contagens de contratos, nunca valores, até existir uma regra de limpeza conferida com outra fonte.
- Uma raiz de CNPJ aparece duas vezes na própria base da Receita, com duas naturezas jurídicas. Sem tratar, ela se multiplicava em toda junção com a tabela de porte.
Esse último ponto merece uma linha. Antes de publicar, a gente foi atrás das contagens que circulam na internet pra ver se batiam. Não batem, e o estudo escreve isso com a conta aberta em vez de tratar o número da moda como referência.
As regras que seguram o número
Tratar dado com IA é rápido. O que faz o resultado aguentar revisão são regras que eu fixei antes de a primeira tabela sair, e que o agente obedece porque estão no repositório, com teste.
Todo número e toda frase do estudo levam um selo: dado observado, estimativa, associação estatística ou hipótese. Hipótese só vira afirmação quando outra fonte confirma, e enquanto isso fica escrito como hipótese, inclusive no site. Onde o critério muda o resultado, o estudo publica a faixa, e a faixa mais importante é a do porte.
107 mil a 213 mil empresas médias ou grandes
O número menor exige capital de R$ 10 milhões e tira as incorporadoras; o maior aceita capital social declarado, a régua mais fraca. Os dois são estimativa, e o estudo publica os dois.
Cada número com rótulo público tem uma linha no livro de números, com ID, fonte, período, selo e a consulta que o gera a partir das tabelas agregadas. O exportador do site liga o texto a esse livro: na capa, 28 números estão ligados a um ID, e o relatório lista os que ficaram como texto solto pra eu decidir um a um.
602
números no livro de números do estudo
Cada um com ID, fonte, período, selo de evidência e a consulta SQL que o reproduz, publicados em CSV junto com os dados
O resto é disciplina de engenharia aplicada a dado. O comando de checagem roda somas por estado, município e setor contra o total, confere que sobrevivência nunca cresce com o tempo e que a população casada com o IBGE dá exatamente 214.211.951; precisa dar zero falhas antes de qualquer exportação. Outros 49 testes conferem as regras sem dado real. Recorte com menos de dez empresas não sai, e nome, CPF e contato nunca entram em tabela nenhuma.
E o site não digita número. Ele só lê um pacote gerado pelo repositório: 13 capítulos, 27 páginas de estado, 41 gráficos, 33 CSVs e o livro de números. Se um número muda, muda na origem, o pacote é gerado de novo e o site importa. Até o Explorador, o painel interativo, foi refeito pra renderizar no servidor, porque uma IA ou um jornalista que abra um link de Campinas sem JavaScript tem que ver os números de Campinas, e não os do Brasil.
Dois modelos, um humano e dois revisores
O pipeline foi escrito no Claude Code, e o primeiro commit já sai assinado pelo modelo. O texto do estudo viveu num documento compartilhado que chegou à revisão 266 antes de ir pro site. No meio, o ChatGPT, no modelo Astra, fez o papel de revisor adversarial, em rodadas registradas no histórico entre 30 de setembro e 8 de outubro; a de 30 de setembro já era a sexta. Foi ele que apontou, por exemplo, que a faixa de porte precisava dizer quantas empresas tinham evidência direta, e que o cruzamento com a CVM media o alcance do cruzamento, e não todo o faturamento acessível ao público. É o mesmo jeito que descrevi no post sobre workflow de desenvolvimento com IA: um modelo faz, outro desconfia.
As decisões ficaram comigo, e estão datadas nos documentos do repositório. Em 7 de outubro decidi que só as 86 páginas de atividade econômica viram páginas indexáveis, e que município e subclasse ficam dentro do Explorador: centenas de páginas no mesmo molde é exatamente o formato que o Google trata como conteúdo em escala, e não quero o domínio da Waxi nessa categoria. Em 9 de outubro decidi antecipar a publicação, que estava marcada pra 17 de novembro. Antes disso, dois revisores humanos leram o estudo: Leonardo Martinez, administrador pelo Insper, e Max Pereira, doutor em ciência da computação pela UFSC. A IA não assina o estudo. A Waxi assina, com coordenação minha.
Por que publicar isso de graça
Ninguém solta um estudo desse tamanho com licença aberta por altruísmo. A Waxi trabalha com dado de empresa brasileira, e um estudo público que qualquer pessoa pode baixar, citar e conferir é a prova de que a gente sabe tratar esse dado. Por isso os CSVs saem em CC BY 4.0, cada página tem "Como citar" e a capa tem o botão de fonte preferida no Google. A aposta: a citação que vale daqui pra frente é a que a IA faz quando alguém pergunta quantas empresas existem no Brasil, e IA cita quem publica número com fonte, data e método.
O que sobrou pra mim
Sobrou a parte que a IA não faz sozinha: saber que candidato de eleição infla o cadastro, desconfiar de uma operadora com 447 mil funcionários, decidir que valor de contrato público não entra enquanto não tiver regra de limpeza, e segurar a publicação de um número até ele ter selo e consulta. Dado público não falta no Brasil. Falta quem aguente conferir. Se quiser acompanhar o que vou escrevendo sobre isso, o feed RSS do blog, o meu LinkedIn e o Instagram danielsilvestre.ai são os lugares.
Perguntas frequentes
Dá pra confiar num estudo feito com IA?
Dá quando o método é público e cada número pode ser refeito por outra pessoa. No Retrato, cada número tem a consulta que o gera, os arquivos de origem têm SHA-256 registrado e as checagens de consistência precisam dar zero falhas antes de exportar. Confiança vem do processo, e o processo está no repositório.
Quais dados públicos de empresas existem no Brasil?
A base é o cadastro de CNPJ da Receita Federal, publicado todo mês. Em cima dele, o estudo cruza IBGE (população, Demografia das Empresas, CEMPRE, PIB), PAT, PGFN, CVM, BNDES, CGU, PNCP e os cadastros da ANS, do CNES, da ANEEL, da ANP, do Inep e da Anatel. A lista completa, com período, licença e o que cada fonte rende, está na metodologia do estudo.
Onde baixar os dados do Retrato das Empresas do Brasil?
Na página de dados do estudo, em CSV, sem cadastro, com fonte, recorte e data de corte de cada arquivo. Os dados e gráficos da Waxi estão em CC BY 4.0; as bases de ANEEL e BNDES seguem a ODbL, e o estudo publica só agregados delas.
Notas
-
PAT é o Programa de Alimentação do Trabalhador. A planilha pública do programa diz quantos trabalhadores cada empresa declara atendidos, e é a única contagem aberta de empregados por CNPJ no país, mesmo sendo um piso. ↩
-
PGFN é a Procuradoria-Geral da Fazenda Nacional, que publica a base aberta da Dívida Ativa da União, com o valor inscrito contra cada CNPJ. ↩
-
Repositório é a pasta versionada onde ficam o código, os testes e a documentação de um projeto, com o histórico de cada mudança. ↩
-
Commit é cada gravação registrada no histórico de um projeto: o que mudou, quem mudou e quando. ↩
-
Agente de IA é um modelo que, além de responder, executa tarefas: roda comandos, escreve e testa código, lê arquivos e corrige o que quebrou, dentro de regras que a pessoa define. ↩
-
Parquet é um formato de arquivo em colunas feito pra análise: ocupa menos espaço que o CSV e permite ler só as colunas que a consulta precisa. ↩
-
DuckDB é um banco de dados analítico que roda dentro de um programa, sem servidor, e consulta arquivos Parquet e CSV direto do disco com SQL. ↩
-
SHA-256 é uma impressão digital matemática de um arquivo. Se um único byte muda, a impressão muda, e por isso ela serve pra provar que o arquivo é o mesmo que foi baixado. ↩
-
CNAE é a Classificação Nacional de Atividades Econômicas, o código que diz o que a empresa faz, da padaria à holding. ↩
Quem escreve
Leia também
Workflow de desenvolvimento com IA: spec, agentes, loops e revisão com dois modelos
Workflow de desenvolvimento com IA na prática: OpenSpec, superpowers, agentes com papel, loop de revisão e Codex revisando o Claude, com os números de dois projetos meus.
IA não faz milagre: sem dados estruturados e cultura de dados não tem ROI
Por que a IA não dá ROI sem dados estruturados e cultura de dados: o que a Gartner mediu, o que aprendi montando a base da Vindi e onde entram MCP, RAG e contexto.
POC com IA em um fim de semana: da ideia ao relatório no cliente sem eu escrever uma linha
Como fazer uma POC com IA ficou barato: 150 commits de sexta a domingo, 400 testes, US$ 37 de API e uma prova de conceito entregue a uma indústria pet antes do contrato.